WISPER: Von Blackbox-KI zu wissensbasierten Prozessmodellen

© Dirk Hanus / Fraunhofer ENAS
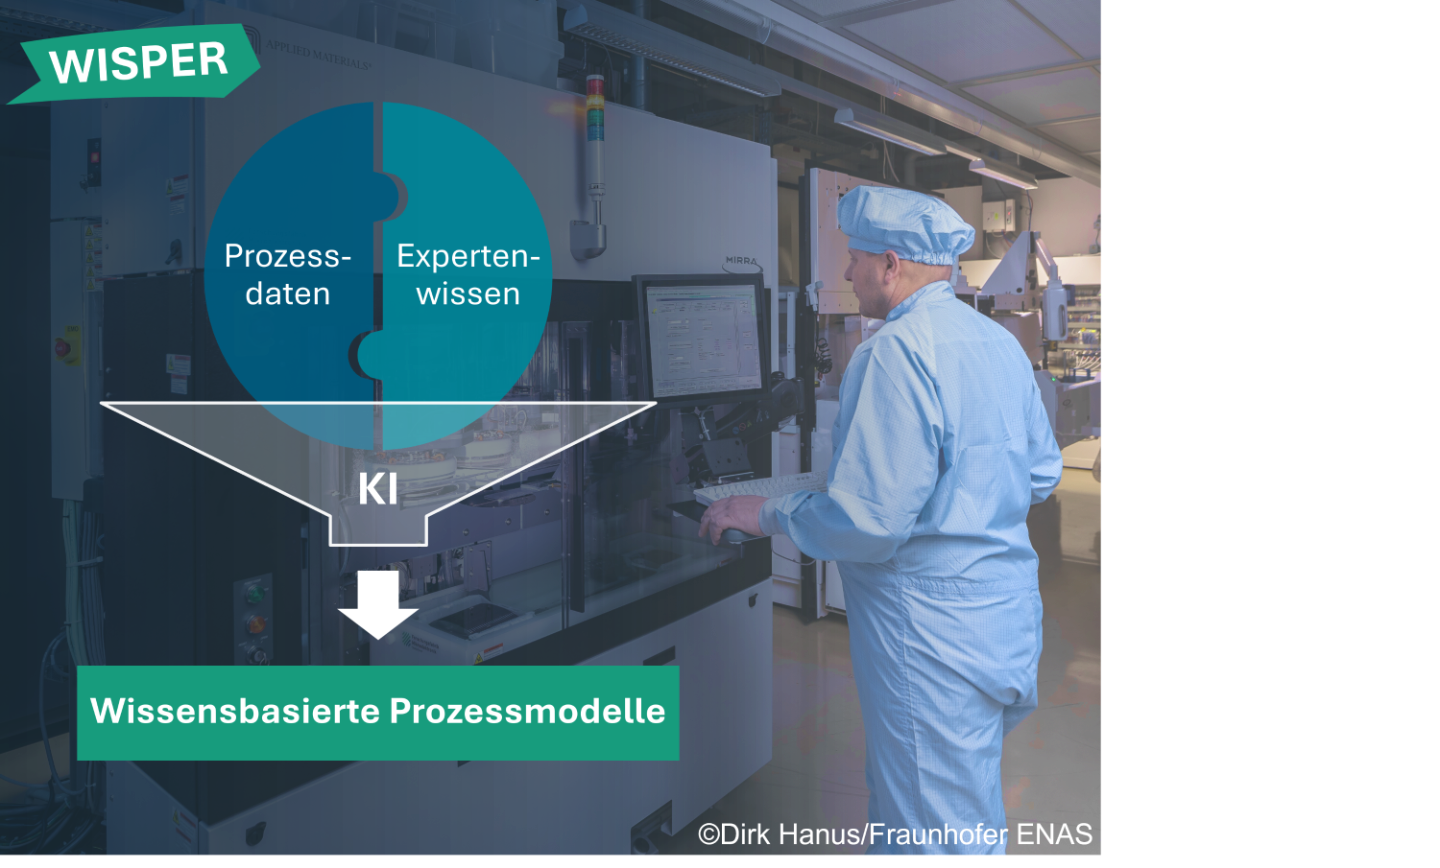
Prozessdaten und Expertenwissen werden über KI zu wissensbasierten Prozessmodellen verbunden.

Künstliche Intelligenz (KI) hat die Halbleiterfertigung erreicht: Viele Demonstratoren sagen inzwischen das Ergebnis von Prozessen vorher. Doch die wenigsten bringen im laufenden Betrieb einen konkreten Nutzen. Woran liegt das?

Dank moderner KI-Werkzeuge können Prozessingenieure heute ganz pragmatisch selbst gute erste Modelle erstellen. Diese versagen jedoch häufig, sobald sich der Prozess ändert – wenn Teile gewechselt werden, neue Produkte eingeführt werden oder Messwerte erst verzögert vorliegen. Solche Fälle lassen sich vermeiden, wenn man sie von Anfang an mitdenkt. Dafür braucht es ein strukturiertes Vorgehen und das Wissen um die typischen Fallstricke.

Data Scientists bringen genau dieses Methodenwissen mit. Für sie liegt die Herausforderung darin, komplexe physikalische Prozesse schnell genug zu durchdringen, um ihre Methoden darauf abzustimmen. Denn Halbleiterprozesse unterscheiden sich drastisch von den etablierten Anwendungsfällen für KI in der Fertigung.


Projektziel: Wissenstransfer in die Industrie

Genau hier setzt das Projekt WISPER an: Gemeinsam mit der TU Chemnitz entsteht eine Weiterbildung für die Industrie, die Prozessingenieure und Data Scientists zusammenbringt. In Impulsvorträgen zeigen wir, woran KI-Projekte in der Fertigung typischerweise scheitern – und anhand konkreter Use Cases aus der Fertigung, wie man mit unserem KEPM-Vorgehensmodell strukturiert zum Ziel kommt. In Workshops vor Ort erschließen Teilnehmende eigene Anwendungsfälle und setzen erste Schritte selbst um.


Was sind wissensbasierte Prozessmodelle?

Wissensbasierte Prozessmodelle (Knowledge-Enhanced Process Models, KEPM) – so nennen wir KI-Modelle, die neben Prozessdaten auch Domänenwissen aus der Halbleiterchipfertigung nutzen, zum Beispiel physikalische Zusammenhänge, Simulationen oder die Erfahrung von Prozessingenieuren. So liefern sie schon mit wenigen Daten genaue Vorhersagen, bleiben bei Prozessänderungen verlässlich und generalisieren auf Situationen, die in den Trainingsdaten nicht vorkommen.

Anhand von Prozessen wie der chemischen Gasphasenabscheidung (CVD), dem Plasmaätzen und dem chemisch-mechanischen Planarisieren (CMP) erforschen wir, wie sich das nötige Domänenwissen erheben, aufbereiten und in die Modelle integrieren lässt.
Das KEPM-Vorgehensmodell

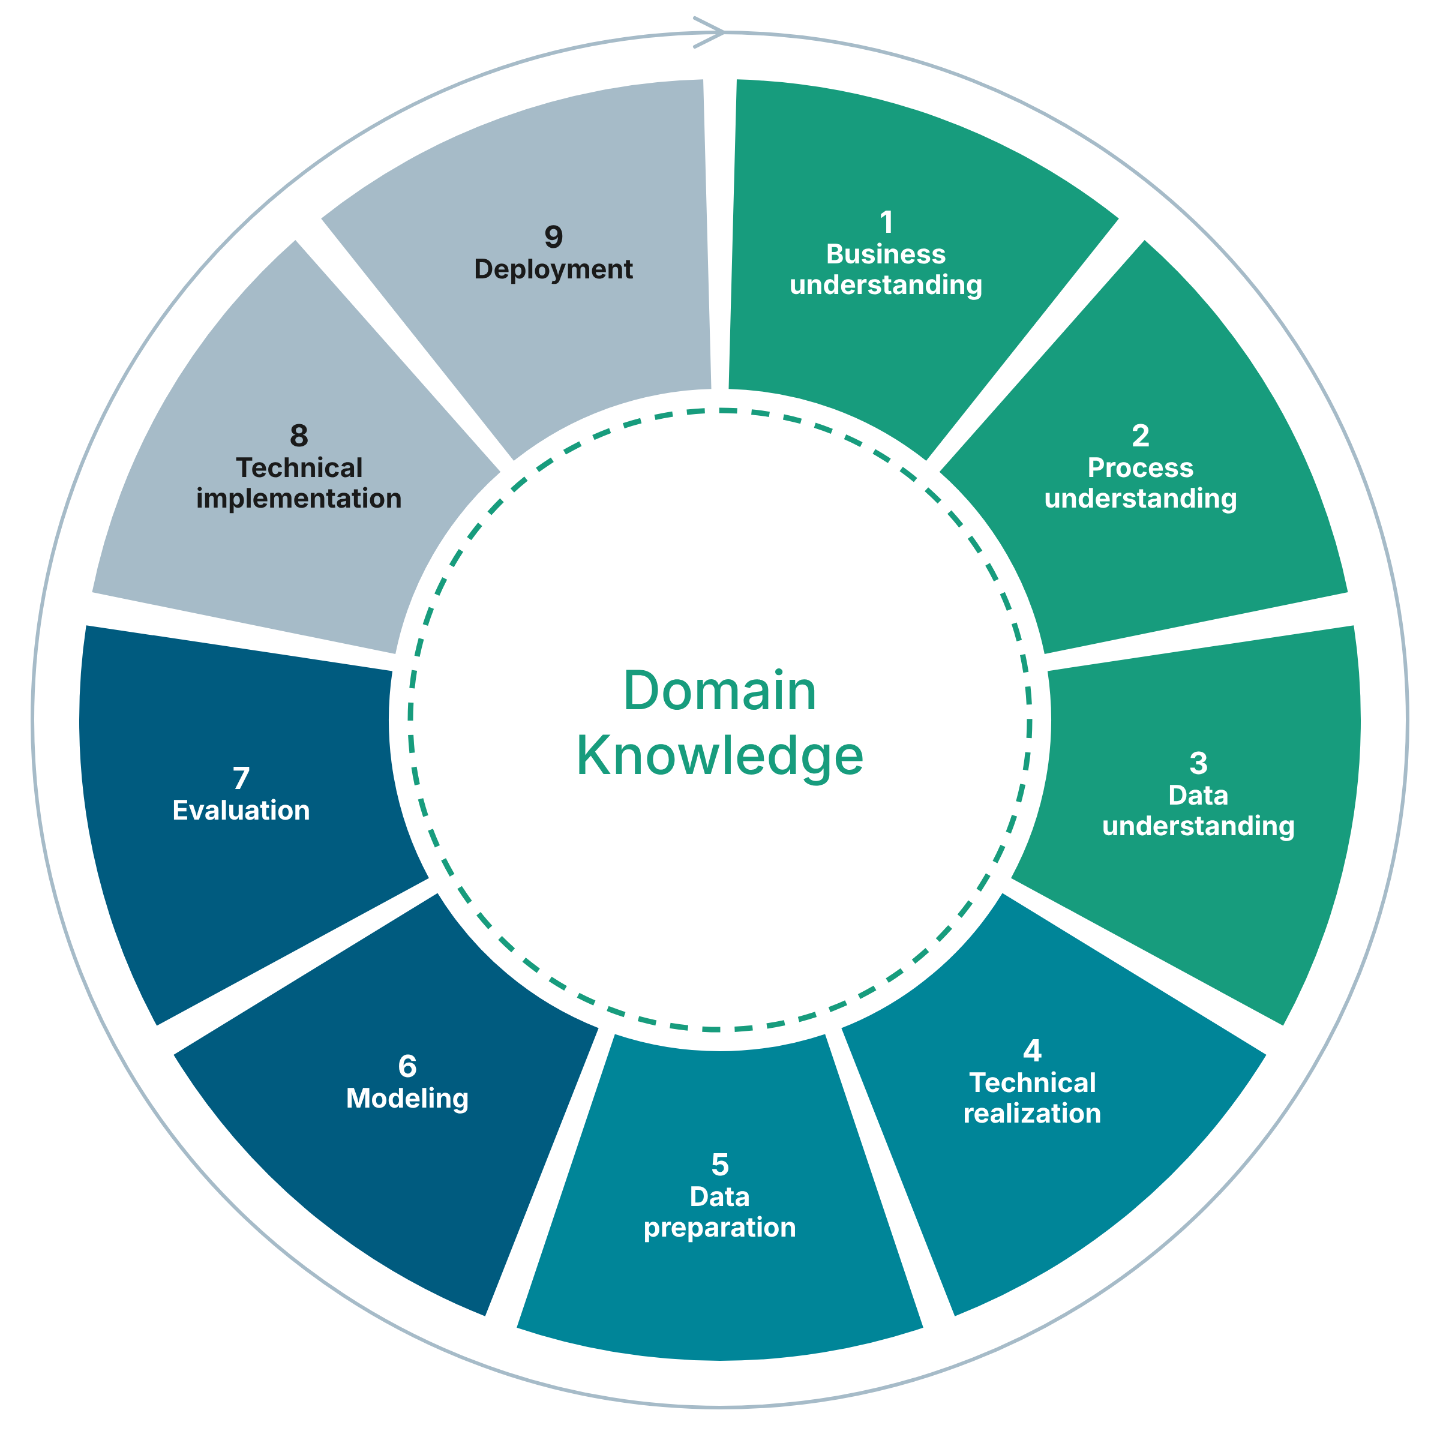
Aus unserer Projekterfahrung und aufbauend auf etablierten Data-Science-Standards wie CRISP-DM haben wir gemeinsam mit der TU Chemnitz das KEPM-Vorgehensmodell entwickelt. Es berücksichtigt die Besonderheiten der Chipfertigung – etwa den Verschleiß von Anlagenteilen, verzögert eintreffende Messwerte und regelnde Eingriffe, die sich in den Daten niederschlagen.

Das Vorgehensmodell umfasst neun Schritte in vier Phasen – Verstehen, Daten, Modell, Betrieb –, die sich in der Praxis mehrfach durchlaufen lassen.

Anders als in einem klassischen Data-Science-Projekt liegt der Schwerpunkt vor allem darauf, den Business Case, den Prozess und die Daten zu verstehen. Hier wird auch das Domänenwissen erfasst, das später in das Modell einfließt.

1 · Business understanding – Ziel und Nutzen klären

Ein erfolgreiches Projekt beginnt nicht mit dem Vorsatz, „irgendetwas mit KI“ zu machen, sondern mit einem klar definierten Business Case. Es lohnt sich, die Projektziele gemeinsam mit Entscheidungsträgern und Prozessexperten festzulegen und zu bestimmen, woran sich der Erfolg messen lässt – auf wirtschaftlicher ebenso wie auf technischer Ebene. Dafür haben wir den KEPM-Projektsteckbrief entwickelt: ein Dokument, das Ziele, Erfolgskriterien und Rahmenbedingungen auf einer Seite festhält.

2 · Process understanding – Den Prozess verstehen

Wie funktioniert der Prozess physikalisch, und wie wird er im konkreten Anwendungsfall gefahren und geregelt? Solche Fragen beantworten sich im Gespräch mit den Prozessexperten. Mit dem Unit Process Canvas haben wir eine Interviewvorlage für diese Gespräche entwickelt, mit der sich das Wissen systematisch erfassen lässt. Weil unausgesprochene Annahmen aufgeschrieben werden, ist sie auch für erfahrene Teams wertvoll. Mit einem Hypothesenbaum entsteht daraus ein priorisierter Arbeitsplan: Welche Fragen müssen zuerst geklärt werden, und welche können warten?

3 · Data understanding – Die Daten kennenlernen

Viele Fehler entstehen, weil Daten sofort ins Modell fließen und dabei Annahmen unhinterfragt übernommen werden. Deshalb gilt es, die Daten zuerst kennenzulernen: Was bedeuten die einzelnen Variablen, wie hängen sie zusammen, und wie gut ist ihre Qualität? Zeigen sich die erwarteten Zusammenhänge, und was überrascht? Bereits hier lassen sich einfache Modelle trainieren, die verraten, wie viel Struktur in den Daten steckt und welche Variablen wie wirken. Für die Dokumentation orientieren wir uns an etablierten Schemata für Datenreports. Außerdem haben wir einen Effektkatalog erarbeitet, der die typischen Effekte in den Daten der Chipfertigung beschreibt.

4 · Technical realization – Einen ersten Datensatz beschaffen

In dieser Phase geht es darum, pragmatisch und schnell an einen ersten Datensatz zu kommen, mit dem sich modellieren lässt. Entscheidend ist, dass er die Informationen enthält, die ein erfolgreiches Modell braucht. Dafür werden die Datenquellen der Fertigung identifiziert und zusammengeführt, etwa Prozess- und Regelungsdaten (FDC, SPC), Anlagendatenbanken, Wartungsprotokolle und Messergebnisse. Mitunter müssen dazu eigene Schnittstellen entstehen, proprietäre Dateiformate gelesen oder zusätzliche Sensoren installiert werden. Zusätzlich bereichert die Versuchsplanung (Design of Experiments) die Datenbasis: Aus früheren oder neu geplanten Experimenten entstehen gezielt Daten zu Einstellungen, die in der Produktion so nicht vorkommen.

5 · Data preparation – Trainingsdaten aufbereiten

In diesem Schritt entstehen aus den Rohdaten die eigentlichen Trainingsdaten für die Modellierung. Dazu muss zunächst die Datenqualität sichergestellt werden. Die Vorverarbeitung geht aber darüber hinaus, denn sie kann die Modellierung erheblich vereinfachen: Mit Domänenwissen lassen sich physikalische Symmetrien ausnutzen, Daten geeignet transformieren und aussagekräftige Eingangsgrößen (Features) ableiten. Besonders wichtig ist die sinnvolle Aufteilung der Daten: Ein Teil der Daten (Testdaten) wird konsequent zurückgehalten, und zusammengehörige Daten, etwa Wafer desselben Produkts oder derselben Anlage, bleiben zusammen. So vermeidet man typische Fehler, die ein Modell besser aussehen lassen, als es ist.

6 · Modeling – Modelle bauen und Wissen integrieren

Hier gilt es zunächst, geeignete Modelle auszuwählen, passend zur Komplexität des Problems und zur Menge der verfügbaren Daten. Anschließend werden die Modelle möglichst effizient trainiert und ihre Hyperparameter optimiert.

Das Besondere an wissensbasierten Prozessmodellen ist, dass hier auch das Domänenwissen ins Modell integriert wird. Wir haben untersucht, welche Art von Wissen (empirische Gleichungen, Faustregeln, physikalische Grundgleichungen) sich in welcher Form (Modellstruktur, Randbedingungen, Vorwissen, zusätzliche Daten) am besten integrieren lässt.

7 · Evaluation – Das Modell bewerten

In dieser Phase geht es darum zu verstehen, wie gut das Modell ist und wie es zu seinen Vorhersagen kommt. In der Literatur steht dabei meist die Genauigkeit im Mittelpunkt, und so konzentriert sich ein Großteil der Forschung auf immer genauere Modelle. In der Praxis zählt jedoch auch, wie interpretierbar ein Modell ist, wie gut es sich übertragen lässt, wie aufwendig sein Betrieb ist und wie robust es bei Änderungen bleibt. Gerade die Robustheit ist in der Halbleiterfertigung entscheidend, denn Prozesse ändern sich laufend, und es werden ständig neue Produkte eingeführt. Für die Evaluation nutzen wir etablierte Methoden und darüber hinaus eigens entwickelte Evaluationsprotokolle.

8 · Technical implementation – Vom Testmodell zum Produktivsystem

Funktioniert ein Modell in der Testumgebung, folgt der Schritt in die Produktion. Dafür braucht es eine Infrastruktur, in der das Modell über lange Zeit stabil läuft und laufend mit Live-Daten versorgt wird. Dazu gehört die finale Softwarearchitektur: Wie werden Daten erfasst und vorverarbeitet, und wo wird das Modell ausgeführt – auf einem Server oder direkt auf einem Edge-Gerät wie einem Mikrocontroller? Ebenso wichtig sind Fragen des Betriebs: Was passiert bei Ausfällen, und wer ist verantwortlich? Auch die Sensorik muss über Monate zuverlässig messen, selbst wenn Sensoren altern.

9 · Deployment – Pilotieren, überwachen, nachjustieren

Ein Modell geht selten direkt in den produktiven Betrieb. Zunächst durchläuft es eine Pilotphase und die in der Industrie üblichen Qualifizierungsprozesse. Auch im finalen Betrieb muss laufend überwacht werden, ob es noch so arbeitet wie erwartet. Falls nicht, wird es angepasst oder neu trainiert – und im Zweifelsfall ist das gesamte Vorgehen noch einmal zu durchlaufen, dann mit einem tieferen Verständnis von Business Case, Prozess und Daten.

Neugierig geworden?

Wir freuen uns darauf, neue Prozesse und Use Cases kennenzulernen und unser Portfolio um weitere Ansätze zu erweitern. Unser Angebot reicht vom Impulsvortrag über kleine Workshops vor Ort bis zum Industrieprojekt, in dem wir wissensbasierte Prozessmodelle gemeinsam umsetzen.

Projektdaten

WISPER wird vom Leistungszentrum »Smart Production and Materials« mit einer Förderung in Höhe von 40.000 Euro unterstützt.

  • Projektpartner: Technische Universität Chemnitz
  • Laufzeit: 01.01.2027 – 31.12.2027

Unsere KEPM-Projekte


CMP-Demonstrator


DaHyME: Datenmanagement und Hybride Prozessmodellierung für die Mikroelektronik


GENESIS: Aufbau einer nachhaltigen Halbleiterindustrie in Europa